从基础到前沿 人工智能芯片设计的书籍与知识体系
引言
随着深度学习和大模型的爆发式增长,人工智能芯片已成为半导体行业最炙手可热的赛道。AI芯片设计并非简单的数字集成电路(Digital IC)的翻版——它需要在传统芯片设计方法之上,融合计算机体系结构、并行计算、低精度数值计算以及算法-硬件协同设计等多学科知识。对于希望进入这一领域的工程师和学生而言,构建一套系统化的知识框架至关重要。本文将结合大连理工大学周巍教授等学者在人工智能芯片设计领域的著作,探讨从数字集成电路基础到AI芯片设计的完整学习路径。
一、人工智能芯片设计的基本知识版图
AI芯片设计本质上属于专用集成电路(ASIC)设计的一个分支。其核心任务是为神经网络推理或训练任务提供高能效、高吞吐量的计算平台。完整的知识体系可以分为三个层次:
- 基础层:数字集成电路设计基础,包括CMOS逻辑门、组合逻辑与时序逻辑、硬件描述语言(Verilog/VHDL)、逻辑综合与静态时序分析。这是任何芯片设计工程师的必修课。
- 架构层:计算机体系结构、并行计算、存储层次、片上网络(NoC)、低功耗设计方法。AI芯片往往采用脉动阵列(Systolic Array)、存内计算(Computing-in-Memory)等新型架构,需要深入理解数据流与重用模式。
- 专用层:神经网络算法与量化、数据流调度、稀疏化加速、可重构计算、EDA工具与敏捷开发方法。
当前市面上优秀的AI芯片设计书籍,正是按照这条脉络逐步展开的。
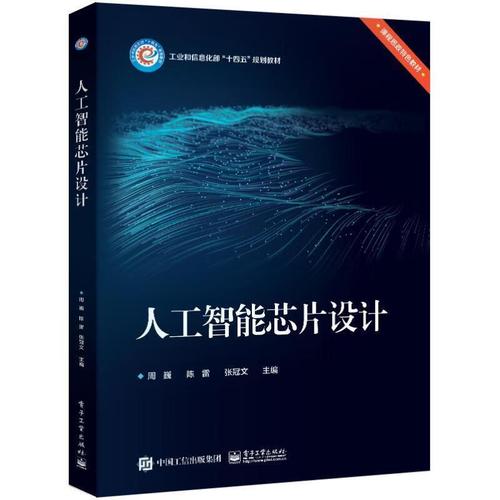
二、周巍教授与《人工智能芯片设计基础》
大连理工大学周巍教授所著的《人工智能芯片设计基础》,是国内较早系统介绍AI芯片设计方法学的教材之一。该书面向高年级本科生和研究生,内容兼顾理论深度与工程实践,其主要特点包括:
- 从电路到系统的贯通:书中既讲解了基本的数字集成电路单元(如加法器、乘法器、寄存器堆)的设计与优化,又将这些单元置于神经网络加速器的整体架构中进行讨论。这种”自底向上“的视角帮助读者建立完整的系统观。
- 数据流与硬件映射:重点分析了卷积神经网络(CNN)和循环神经网络(RNN)在硬件上的映射方法,包括权值固定(Weight Stationary)、输出固定(Output Stationary)等数据流策略。
- 能效与面积权衡:针对AI芯片对能耗的严苛要求,书中详细介绍了低功耗设计技术,如时钟门控、电压频率调整(DVFS)以及近似计算。
- 实例驱动:通过简化的脉动阵列或FPGA原型案例,让读者理解从算法到RTL、再到版图的全流程。
尽管书名包含”基础“二字,但其内容并不浅显。它要求读者已经掌握数字电路和计算机组成原理,然后才能无缝过渡到AI加速器的设计方法。如果你正在寻找国内原创的、结合中文教学体系的人工智能芯片设计入门书,周巍教授的这本著作是值得首选的一本。
三、数字集成电路:AI芯片设计的基石
无论AI架构如何新颖,最终都要落实到CMOS晶体管和逻辑门。因此,扎实的数字集成电路知识是进入AI芯片领域的门票。一个合理的学习顺序如下:
- 数字逻辑设计:理解布尔代数、卡诺图、组合逻辑(译码器、多路选择器、加法器)和时序逻辑(触发器、计数器、状态机)。教材方面,国外经典如Harris和Harris的《数字设计与计算机体系结构》,国内如阎石《数字电子技术基础》均广受认可。
- Verilog HDL与验证:掌握可综合的RTL编码风格,学习如何编写testbench、进行功能仿真和时序仿真。常用的工具链包括Synopsys VCS、Cadence Xcelium、开源Icarus Verilog等。
- CMOS VLSI设计:Weste和Harris的《CMOS VLSI Design》是必读经典,它深入讲解了MOS管的工作原理、CMOS反相器、组合逻辑和时序逻辑门的晶体管级实现、互连寄生参数、功耗分析与优化。
- 逻辑综合与后端设计:理解从RTL到门级网表(综合)、再到版图(布局布线)的全流程。需要熟悉标准单元库、时序约束(SDC)、静态时序分析(STA)和物理验证(DRC/LVS)。
一般来说,以上内容覆盖了本科三、四年级到研究生一年级的课程。对于AI芯片设计而言,虽然不需要手动绘制版图,但清楚地知道综合工具进行了什么优化、时序为何不满足,对于调试加速器设计至关重要。
四、从数字集成电路到AI芯片设计:相通的技能升级
传统数字芯片工程师转型做AI芯片,并不是从头再来,而是知识体系的自然扩展。具体来说,以下数字IC技能可以直接迁移:
- 硬件描述语言:仍然是Verilog(部分场景用SystemVerilog或Chisel)。高级综合(HLS)工具(如Vitis HLS)则允许从C/C++生成RTL,能加速AI加速器核心的开发与迭代。
- 流水线与并行化:在数字设计中已熟悉的流水线技术、空间并行和时间复用等直觉,正巧是AI加速器设计的关键洞见。例如,脉动阵列中每个处理单元(PE)就是乘法器加累加器的流水化结构。
- 低功耗技术:时钟门控、操作数隔离、多阈值电压等技术,在数字后端中已经广泛使用,这些同样是AI芯片为达到数TOPS/W能效所必须的手段的石。
但在升级过程中,我们需要打破原有的通用CPU设计思维:不再追求指令集的通用性与缓存一致性,而是为某个特定的张量运算集合定制硬件;不再要求计算的全精度,甚至可拥抱定点和低位宽浮点来计算以减少能耗和面积。学习AI芯片设计就是要在这几个方面改变思路。
五、更广泛的学习资源与工具
除了周巍教授的《人工智能芯片设计基础》,更广泛地构建知识谱系还需要用到以下资源:
- 电路基础:《数字集成电路:电路、系统与设计》(Rabaey)讲得更透彻而更偏电路,可以作为CMOS VLSI的进阶读物。
- 体系结构:《计算机体系结构:量化研究方法》(Hennessy & Patterson)、《芯片体系结构》 提供了AI加速器的审视框架。Daniel So或David Patterson关于TPU、领域专用架构的重要文献还要看原文。
- 神经网络基础:花书《深度学习》、CS231n关于卷积网络的章节可以告诉我们加速器正在跑的到底是什么计算。了解反向传播和对矩阵运算的优雅覆盖将有事半功倍的增益。
- 实战与研究:Coursera、edX上有EECS151&开源流水教程(University of Washington芯片设计),可系统做完整架构项目。Arxiv上与 TPU、DaVinic、GraphCore、Reconfig与精度的论文都可获得前沿第一手的数据。
开源社区工具可作为自身培训经验的支持桩( RTL 使用 Veri考练平台诸如Verilator配对 Jupyter)。在NVIDIA课程环节或是ACE Design上你可以尝试由Mac会所提倡的那种版图执行复现技能最小封闭创新实现产品提升自己的核心竞争力以便响应企业的实现高效硬核化程序设计议题。如果你所在工厂正立图做好Fin-Etch开发或者试提出新兴记忆工艺布局时更加笃信算力之路即是组合数学与算术杂着环境生态三事最大交圈会具有重大的启发联动效果。如今推理正密走”电力就是限制围箍发展尖端算述之根本悖律改革发生由Sim到浮点到Micro新板块争抢多模式自译芯结合小芯片形成赢局生态站外新擂台。
o-width: ? P、横向展开 R。好其实最终呈上面所述的几类大致构建了“前端系统拥型变换效率所需所有常见素养”。
六、
设计人工智能芯片,需要一个分层而统一的知识策略:从晶体管N舞通过钟摆时序汇聚成的计算流体开始修行逻辑圣人的道口接着混入类层级网络拟合的求参经过程辑而为高能流水架构制硬件创造—如果掌握那些条律法你很快会发现当芯片速度更新犹如雨后泛波迅速占据各类领袖序列。这条路径诚然颇有挑战但不失探:选择周巍教授《人工智能芯片设计基础》定固基线,从读数有序地和典型项目配套实操一定会让你一步步环扣拥有人领不能随手比拟的时代力气吗而已能在简历熠熠生能取代夸赞虚言而得攻坚心满意域宽建算链里程: 由于AI热潮一时与努力修炼坚艺才是变人才不变局的大引擎罢了自此切入题言数陈完成全文了吧。
如若转载,请注明出处:http://www.xingqiu100.com/product/41.html
更新时间:2026-10-22 04:16:16